1. Концепция превентивного мониторинга
Главная цель корпоративного мониторинга — обнаружить и ликвидировать проблему до того, как ее заметят конечные пользователи или руководство. Система отслеживает тренды заполнения дисковых массивов, скачки очередей процессора и деградацию сетевых каналов.
- Zabbix Agent 2 с поддержкой активных проверок и буферизацией метрик при обрыве связи.
- SNMP v3 мониторинг управляемых коммутаторов Cisco, MikroTik и источников бесперебойного питания APC.
- IPMI/iLO аппаратные датчики температуры процессоров, состояния вентиляторов охлаждения и блоков питания.
2. Визуализация в Grafana и дашборды NOC
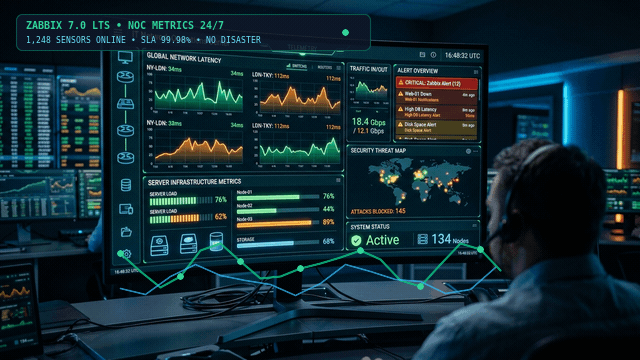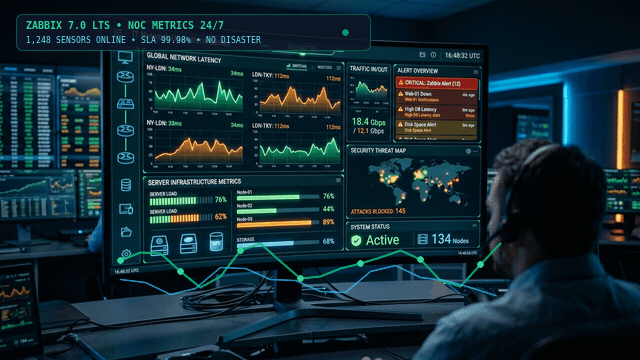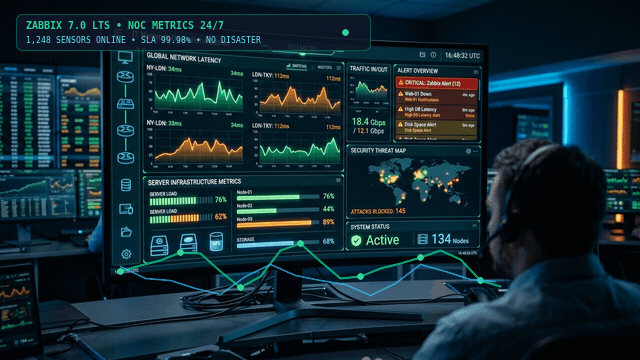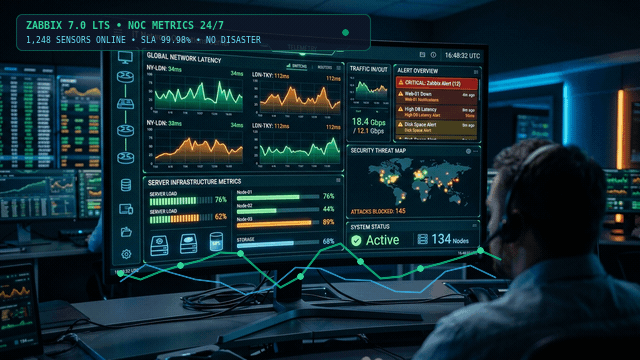
Для оперативного анализа информации созданы экраны мониторинга в Grafana, отображающие тепловую карту серверов, статус каналов провайдеров, объем трафика и задержки до критических узлов.
3. Инцидент-менеджмент и умные оповещения
Алерты классифицируются по шкале от Information до Disaster. Ночные уведомления отправляются только при сбоях уровня High и Disaster, что исключает усталость инженеров от ложных тревог (Alert Fatigue).
Инженерные сервисы в данном направлении:
Система мониторинга Zabbix 7.0 LTS
Мониторинг физических серверов, виртуальных машин, температуры ЦОД, SMART дисков и служб ОС.
Метрики Prometheus & Дашборды Grafana
Визуализация ключевых индикаторов производительности в реальном времени на экранах дежурной смены NOC.
Uptime Kuma & Внешний мониторинг
Контроль доступности внешних сайтов, API, SSL-сертификатов и DNS-серверов из разных точек планеты.
Система эскалации алертов в Telegram
Мгновенное оповещение дежурного системного администратора в мессенджер с уровнем приоритета сбоя (Warning / Disaster).